

The dataset viewer is not available for this split.
Error code:   StreamingRowsError
Exception:    ValueError
Message:      Protocol not known: memory
Traceback:    Traceback (most recent call last):
                File "/src/services/worker/src/worker/utils.py", line 149, in get_rows_or_raise
                  return get_rows(
                      dataset=dataset,
                  ...<4 lines>...
                      column_names=column_names,
                  )
                File "/src/libs/libcommon/src/libcommon/utils.py", line 272, in decorator
                  return func(*args, **kwargs)
                File "/src/services/worker/src/worker/utils.py", line 129, in get_rows
                  rows_plus_one = list(itertools.islice(safe_iter(ds, dataset=dataset), rows_max_number + 1))
                File "/src/services/worker/src/worker/utils.py", line 489, in safe_iter
                  yield from ds.decode(False) if ds.features else ds
                File "/usr/local/lib/python3.14/site-packages/datasets/iterable_dataset.py", line 2818, in __iter__
                  for key, example in ex_iterable:
                                      ^^^^^^^^^^^
                File "/usr/local/lib/python3.14/site-packages/datasets/iterable_dataset.py", line 2365, in __iter__
                  for key, example in self.ex_iterable:
                                      ^^^^^^^^^^^^^^^^
                File "/usr/local/lib/python3.14/site-packages/datasets/iterable_dataset.py", line 315, in __iter__
                  for key_example in islice(self.generate_examples_fn(**gen_kwargs), shard_example_idx_start, None):
                                     ~~~~~~^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
                File "/usr/local/lib/python3.14/site-packages/datasets/packaged_modules/webdataset/webdataset.py", line 130, in _generate_examples
                  for example_idx, example in enumerate(self._get_pipeline_from_tar(tar_path, tar_iterator)):
                                              ~~~~~~~~~^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
                File "/usr/local/lib/python3.14/site-packages/datasets/packaged_modules/webdataset/webdataset.py", line 32, in _get_pipeline_from_tar
                  fs: fsspec.AbstractFileSystem = fsspec.filesystem("memory")
                                                  ~~~~~~~~~~~~~~~~~^^^^^^^^^^
                File "/usr/local/lib/python3.14/site-packages/fsspec/registry.py", line 302, in filesystem
                  cls = get_filesystem_class(protocol)
                File "/usr/local/lib/python3.14/site-packages/fsspec/registry.py", line 239, in get_filesystem_class
                  raise ValueError(f"Protocol not known: {protocol}")
              ValueError: Protocol not known: memory
Need help to make the dataset viewer work? Make sure to review how to configure the dataset viewer, and open a discussion for direct support.
Corn Leaf Diseases, Pests and Deficiencies
Dataset de imágenes de hojas de maíz para la clasificación de enfermedades, plagas y deficiencias nutricionales. Forma parte de Doctor Maíz, un sistema de diagnóstico offline pensado para pequeños agricultores de El Salvador.
Sobre este corpus se entrenó el modelo desplegado en la aplicación móvil del proyecto: EfficientNet-Lite0 cuantizado a Int8, de 3.5 MB, con macro-F1 de 0.9468 sobre un conjunto de prueba independiente de 5 015 imágenes.
Enlaces
- Repositorio del proyecto: https://github.com/daiv05/maize-doctor-classifier
- Documentación del dataset y del proyecto (por ahora solo en español): https://doctor-maiz.deras.dev/
- Notebook de análisis exploratorio (EDA) completo:
notebooks/01_eda.ipynb - Dataset de segmentación de instancias de hoja, del mismo proyecto:
daiv05/corn-leaf-instance-segmentation
Ficha técnica
| Campo | Valor |
|---|---|
| Total de imágenes | 33 437 |
| Número de clases | 9 |
| Entornos de captura | lab 3 551 · real 29 886 |
| Duplicados eliminados (pre-limpieza) | 8 538 imágenes en 8 050 grupos (pHash, imagededup) |
| Formato | JPEG/JPG mayoritariamente, algunos PNG |
| Resolución | Heterogénea — ancho/alto entre 54 px y 5184 px (mediana 640×640 px) |
| Tamaño total en disco | ~19 GB |
Licencia y procedencia
El corpus no es una obra original: consolida ocho fuentes públicas de imágenes de maíz, cada una con su propia licencia. Tres de ellas —Maize in Field, Maize Diseases (PlantVillage) y CropDG Unified Multidomain— se publican bajo CC BY-NC-SA 4.0. Su cláusula ShareAlike obliga a que cualquier obra derivada mantenga los mismos términos, y su cláusula NonCommercial prohíbe el uso comercial. Por eso el conjunto agregado se publica bajo CC BY-NC-SA 4.0: es la licencia más restrictiva de las fuentes combinadas, y no puede relajarse aguas abajo.
En la práctica esto significa que el dataset puede usarse para investigación, docencia y trabajo académico, con atribución, pero no para productos o servicios comerciales, y que cualquier redistribución o derivado debe conservar la misma licencia.
El código del proyecto que produce y consume este dataset sí es MIT; la licencia del código y la de los datos son independientes. El detalle de licencia por fuente está documentado en la tabla de datasets del repositorio.
Estructura del repositorio
Las imágenes se distribuyen en shards .tar (clean-00000.tar … clean-00022.tar, ~800 MB cada uno) en lugar de archivos sueltos: son ~33 k imágenes, y publicarlas como blobs individuales haría que cada descarga completa implicara ~33 k peticiones HTTP.
Dentro de cada shard, las imágenes conservan el árbol <clase>/<entorno>/<archivo>, así que al extraerlos todos sobre un mismo directorio se reconstruye:
<clase>/
├── lab/
└── real/
Se incluye además metadata ligera (sin bytes de imagen):
| Archivo | Contenido |
|---|---|
metadata.csv |
file_name, label, environment — una fila por imagen |
dataset_infos.json |
Esquema, clases y conteos por clase/entorno |
El entorno (lab/real) viaja tanto en la ruta como en metadata.csv, y además está codificado en el nombre de cada archivo (..._lab_... / ..._real_...).
Descarga
from huggingface_hub import snapshot_download
import tarfile, pathlib

destino = pathlib.Path("clean")
snapshot_download(
    repo_id="daiv05/corn-leaf-diseases-pests-and-deficiencies",
    repo_type="dataset",
    local_dir=destino,
)
for tar_path in sorted(destino.rglob("*.tar")):
    with tarfile.open(tar_path) as tf:
        tf.extractall(destino, filter="data")
    tar_path.unlink()
En el repositorio del proyecto esto está automatizado en scripts/dataset/download_dataset.py (make download-dataset).
Clases y distribución
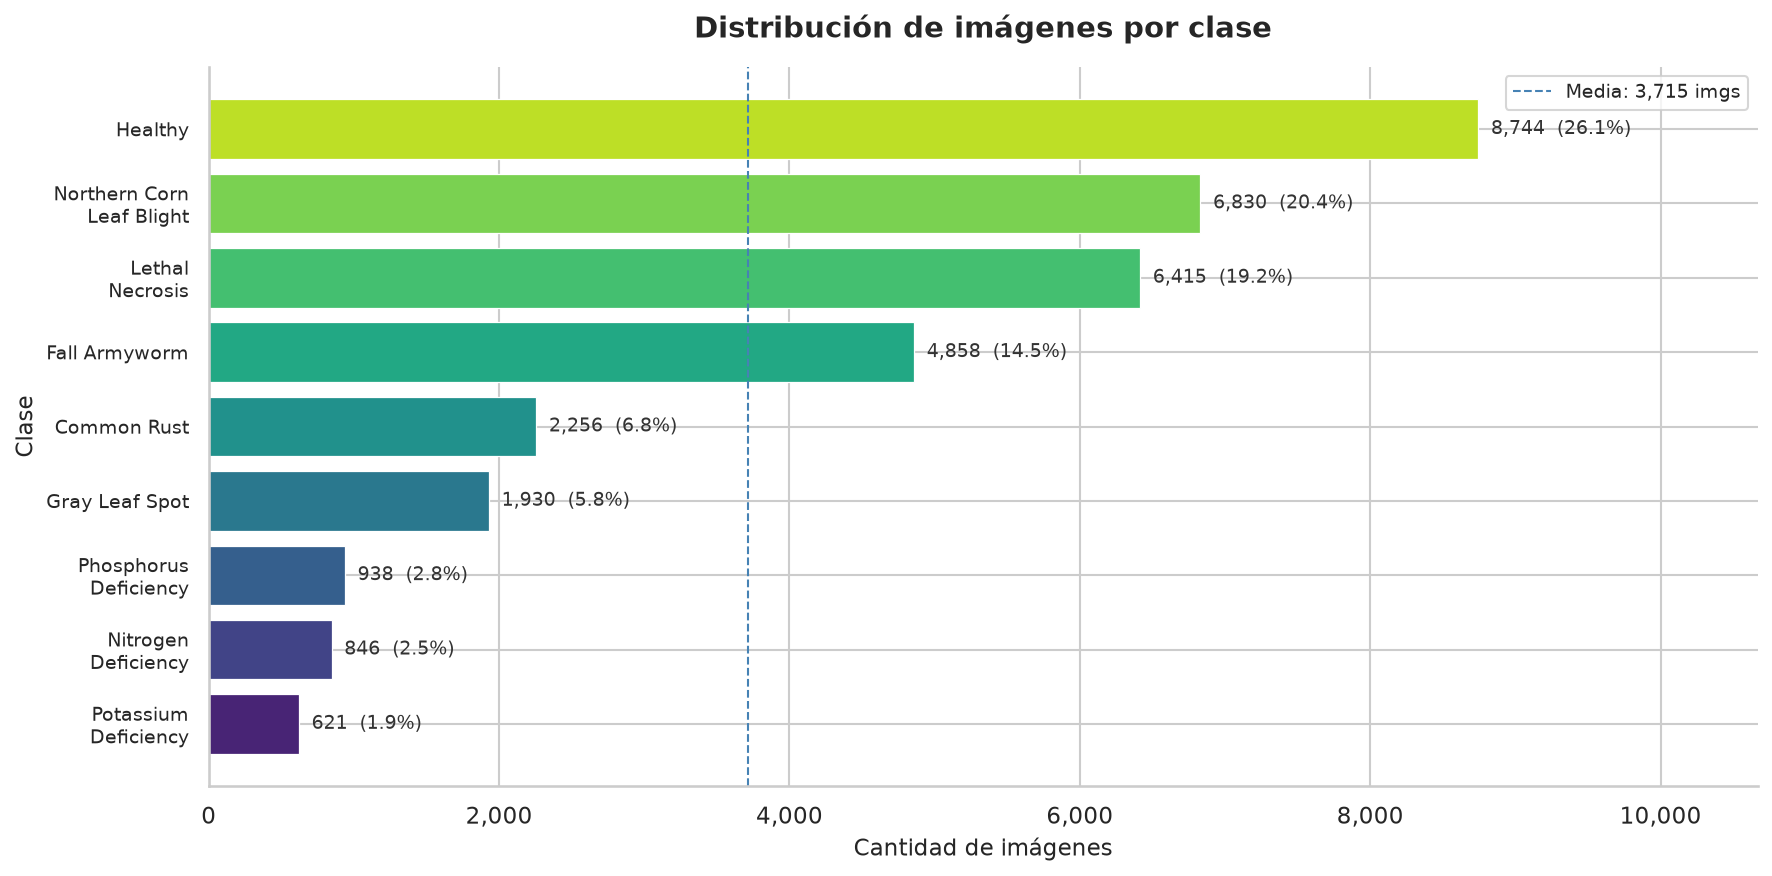
| Clase | Total | Lab | Real | % lab | % del dataset |
|---|---|---|---|---|---|
healthy — hoja sana |
8 744 | 0 | 8 744 | 0 % | 26.15 % |
northern_corn_leaf_blight — tizón foliar norteño |
6 830 | 888 | 5 942 | 13.0 % | 20.43 % |
lethal_necrosis — necrosis letal del maíz (MLN) |
6 415 | 0 | 6 415 | 0 % | 19.19 % |
fall_armyworm — gusano cogollero |
4 857 | 0 | 4 857 | 0 % | 14.53 % |
common_rust — roya común |
2 256 | 2 150 | 106 | 95.3 % | 6.75 % |
gray_leaf_spot — mancha gris de la hoja |
1 930 | 513 | 1 417 | 26.6 % | 5.77 % |
phosphorus_deficiency — deficiencia de fósforo |
938 | 0 | 938 | 0 % | 2.81 % |
nitrogen_deficiency — deficiencia de nitrógeno |
846 | 0 | 846 | 0 % | 2.53 % |
potassium_deficiency — deficiencia de potasio |
621 | 0 | 621 | 0 % | 1.86 % |
El dataset presenta un desbalance severo: healthy supera en ~14.1× a potassium_deficiency. Se recomienda usar muestreo ponderado (WeightedRandomSampler) y/o augmentation adicional para las clases minoritarias en lugar de solo re-ponderar la loss.
Condiciones de captura (lab vs. real)
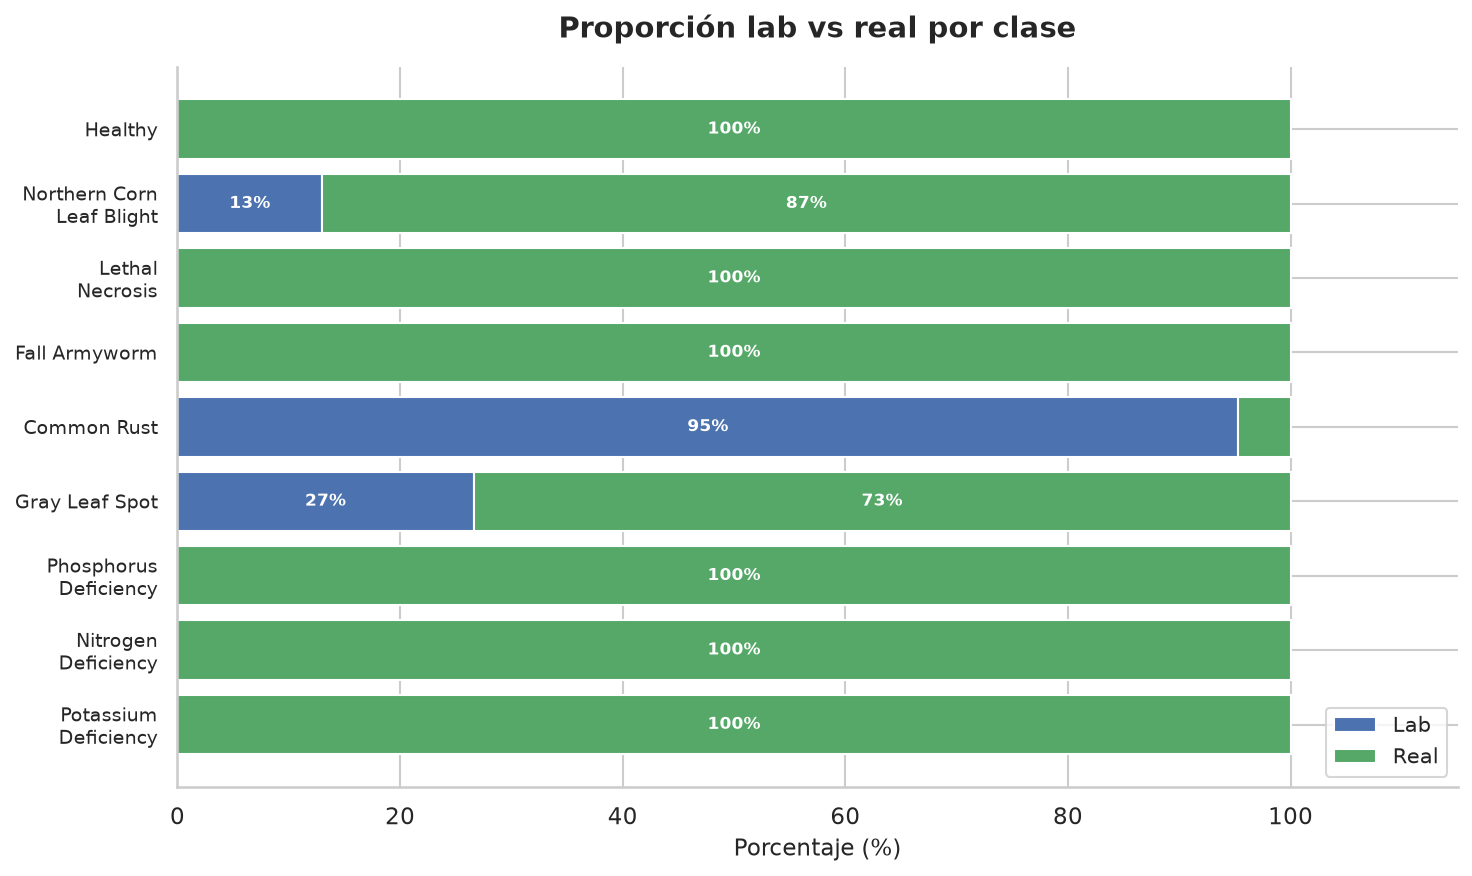
| Contexto | Descripción |
|---|---|
lab |
Fondo uniforme (negro/blanco/gris), entorno controlado, iluminación artificial, distancia corta y constante. Típico de PlantVillage. |
real |
Campo abierto, fondo natural variable, iluminación solar variable, diversidad de distancias y ángulos. |
common_rust es la clase con mayor sesgo de dominio: 95.3 % de sus imágenes provienen de laboratorio, con fondo uniforme. Un modelo entrenado sin cuidado podría aprender a reconocer el fondo en vez de los síntomas foliares reales.
Sesgo de procedencia: la advertencia importante
El riesgo mayor de este corpus no es el desbalance de clases sino la fuga por procedencia. Las clases provienen de repositorios distintos, y cada repositorio tiene su propia cámara, iluminación y fondo. Una partición estratificada clásica deja imágenes de la misma fuente a ambos lados del split, y el modelo puede resolver la tarea reconociendo el origen de la foto en lugar de la lesión foliar.
En el proyecto esto se midió: con partición estratificada el macro-F1 sobre test es 0.9468, pero al evaluar con leave-one-source-out —entrenando sin una fuente y evaluando sobre ella— cae a 0.6026 ± 0.1240. La diferencia entre ambas formas de partir los datos pesa más de 66 desviaciones estándar, mientras que cualquier ajuste de hiperparámetros mueve entre 1 y 2.
Quien use este dataset debería reportar, junto a su métrica, cómo particionó: una cifra alta bajo partición estratificada no predice el comportamiento en una parcela nueva.
Splits
El dataset se publica sin división train/val/test: los splits se generan de forma reproducible en el proyecto (scripts/pipeline/create_splits.py, semilla 42, estratificación por label + environment, deduplicación por SHA-256). Esto permite regenerarlos con distintos criterios —incluida la partición agrupada por fuente descrita arriba— sin volver a publicar las imágenes.
Resolución de las imágenes
Medido sobre una muestra estratificada de 3 466 imágenes (hasta 400 por clase):
| Métrica | Mínimo | Mediana | Máximo |
|---|---|---|---|
| Ancho (px) | 54 | 640 | 5 184 |
| Alto (px) | 54 | 640 | 5 184 |
| Megapíxeles | 0.003 | 0.410 | 20.155 |
| Aspect ratio (w/h) | 0.34 | 1.00 | 4.11 |
Las imágenes de la fuente corn_leaf_roboflow ya vienen fijas a 640×640 px; el resto conserva su resolución original.
Cita
Si usas este dataset, cita el proyecto y respeta además las licencias de las fuentes originales:
@misc{doctormaiz2026corn,
  title  = {Corn Leaf Diseases, Pests and Deficiencies},
  author = {Rivas Fuentes, Josias Abner and Deras Cerros, David Alejandro and Rosales Molina, Elmer Edenilson},
  year   = {2026},
  note   = {Universidad de El Salvador},
  howpublished = {\url{https://huggingface.co/datasets/daiv05/corn-leaf-diseases-pests-and-deficiencies}}
}
- Downloads last month
- 174